预定义类别
定义要提取的类别,或从Skimle的建议的字段中选择,然后让分析根据这些类别对您的文档进行分类。
预定义类别是您想要决定数据分析结果时使用的分析模式。您命名要提取的类别,Skimle 根据这些类别对每份文档进行分类,然后根据所发现的内容形成子类别。
这涵盖了归纳-演绎范围的两端。若您带入自己已有的分类框架,分析即为演绎式。从 Skimle 的建议的字段开始,或从一个宽泛的类别开始,让子类别从数据中产生,分析即为归纳式。相同的屏幕,相同的工作流程。
第 1 步:选择您的类别
有两种方法可以填充类别列表,您可以同时使用这两种方法:
- 自行添加。 点击添加您自己的类别并为其命名。这是您已经知道查找内容时应采用的方法。
- 从建议的字段中选择。 Skimle 会读取您的项目,并从资料本身提炼出建议类别。点击其中一个即可添加。这是您希望让数据主导时应采用的方法。
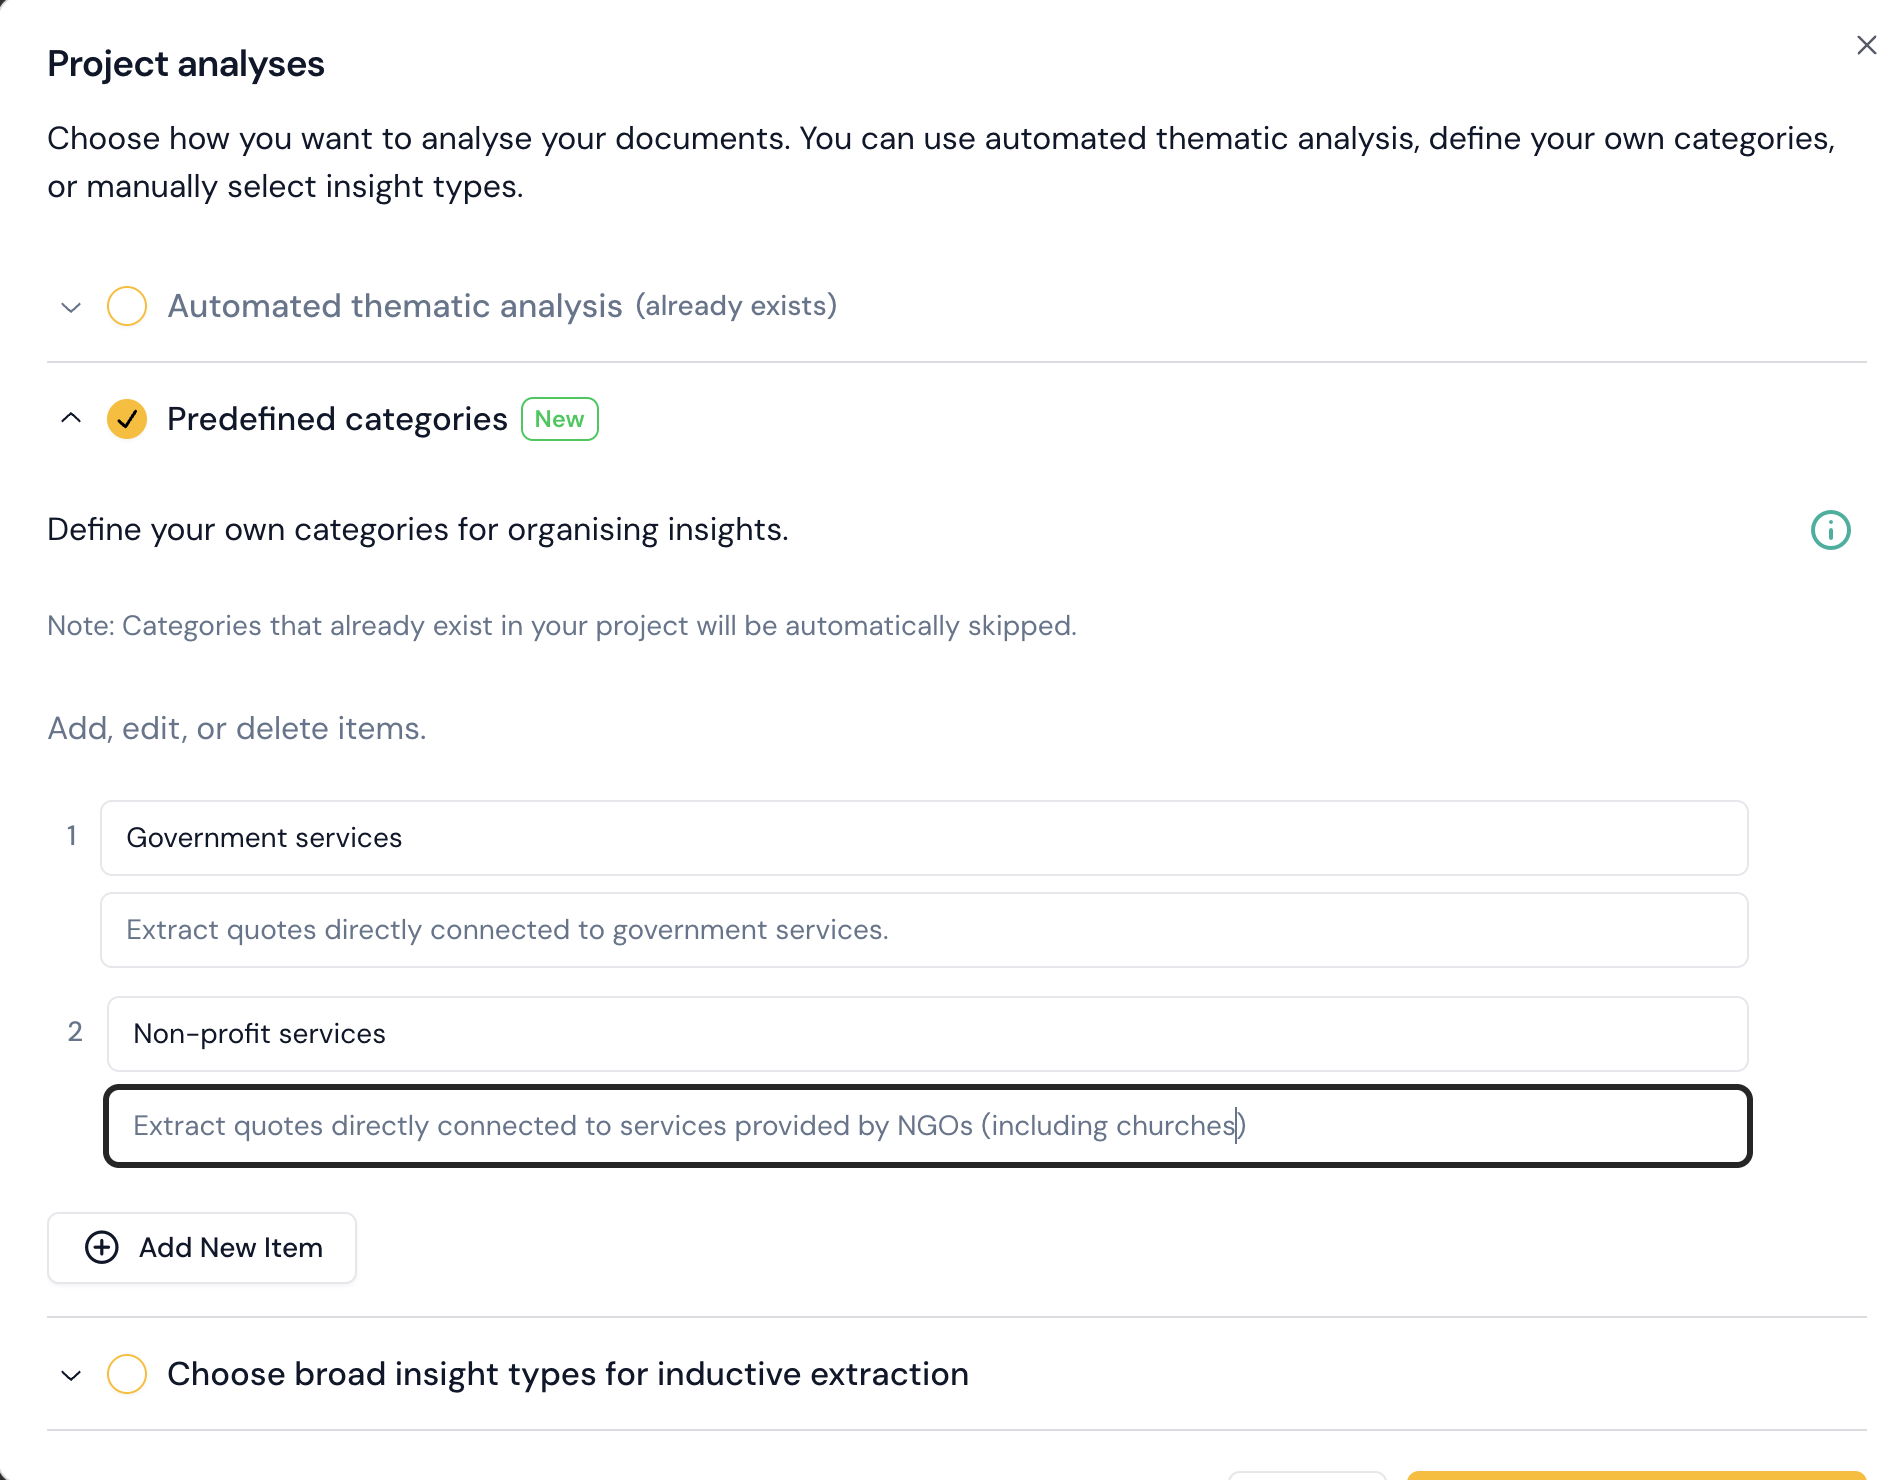
每个类别都可以附带可选的说明:
- 说明用于指导 AI 针对该类别提取的内容,让您可以扩大或缩小包含的内容范围。
- 分类说明用于指导洞察如何被归入其下的子类别。
- 示例可以生成,用于在您开始完整运行之前,预览 AI 将找到的洞察类型。
没有说明的类别同样可以正常运作。当类别名称本身含糊不清,或两个类别都可能涵盖同一段落时,说明就显得尤为重要。
第 2 步:数据提取
Skimle 会逐一检查您的每份文档,提取与您的类别及其说明相匹配的洞察。每条提取的引文都会与源文档进行核对,因此未在原文中逐字出现的引文永远不会进入您的分析结果。
第 3 步:子类别由洞察形成
Skimle 会检查分配给每个类别的洞察,并形成子类别,然后将每条洞察移动到最合适的子类别中。这正是归纳式分析获得结构的地方:您提供宽泛的焦点,而其下的层级则来自数据本身。
注意:只有当某个类别分配到的洞察数量达到一定规模时,才会形成子类别。 如果一个类别只捕获了少量洞察,它将保持扁平结构,这通常表明该类别定义过窄,或相关素材并不存在。
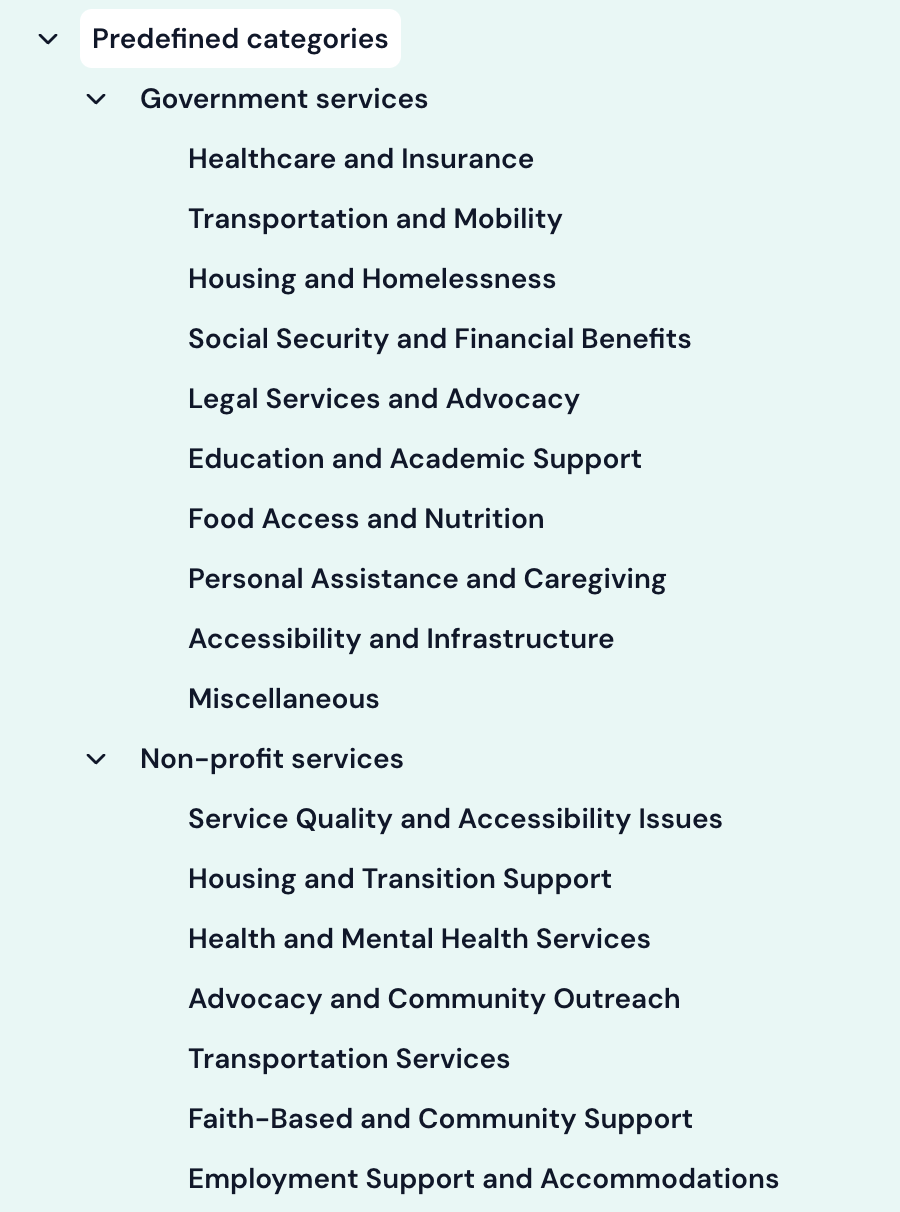
第 4 步:类别摘要
数据分类完成后,Skimle 会为每个类别撰写摘要。摘要可在类别视图中查看,您也可以在那里对分析结果进行重命名、合并、拆分和重新组织。
CSV 文件导入
当您导入 CSV 文件时,“content”列的名称会被保存,并用于为此分析类型创建默认类别。这也是在导入数据之前,为其设置清晰且信息丰富的标题行的另一个理由。有关 CSV 导入工作原理的更多信息,请参阅支持的文件格式与 CSV 导入。
何时使用它
只要您知道分析应在类别层面回答什么问题,无论这些类别来自您自己的框架还是来自 Skimle 的建议的字段,都可以使用预定义类别。如果您的文档具有共同的结构,并且您希望完全无需任何输入即可基于该结构构建类别,自动主题分析会更快。如果您想要针对研究问题获得书面分析性答案,而不是一个分类形成的类别树,请使用智能体分析。