사전 정의된 카테고리
추출할 카테고리를 정의하거나 Skimle의 제안에서 선택하고, 분석이 이를 기준으로 문서를 분류하도록 하십시오.
사전 정의된 카테고리는 데이터에서 무엇이 도출될지 직접 결정하고자 할 때 사용하는 분석 유형입니다. 추출할 카테고리의 이름을 지정하면 Skimle이 모든 문서를 해당 카테고리에 따라 분류하고, 그 결과를 바탕으로 하위 카테고리를 형성합니다.
이 기능은 귀납-연역 범위의 양 끝을 모두 포괄합니다. 이미 가지고 있는 분류 체계를 사용하면 연역적 분석이 됩니다. Skimle의 제안이나 하나의 넓은 카테고리에서 시작해 하위 카테고리가 데이터에서 자연스럽게 드러나도록 하면 귀납적 분석이 됩니다. 화면과 작업 흐름은 동일합니다.
1단계: 카테고리 선택
카테고리 목록을 채우는 방법은 두 가지이며, 두 방법을 함께 사용할 수도 있습니다:
- 직접 추가하기. 직접 카테고리 추가를 클릭하고 이름을 지정하십시오. 이미 찾는 대상을 알고 있을 때 선택하는 방법입니다.
- 제안에서 선택하기. Skimle이 프로젝트를 분석해 자료 자체에서 도출한 카테고리를 제안합니다. 원하는 카테고리를 클릭하여 추가하십시오. 데이터가 방향을 이끌도록 하고자 할 때 선택하는 방법입니다.
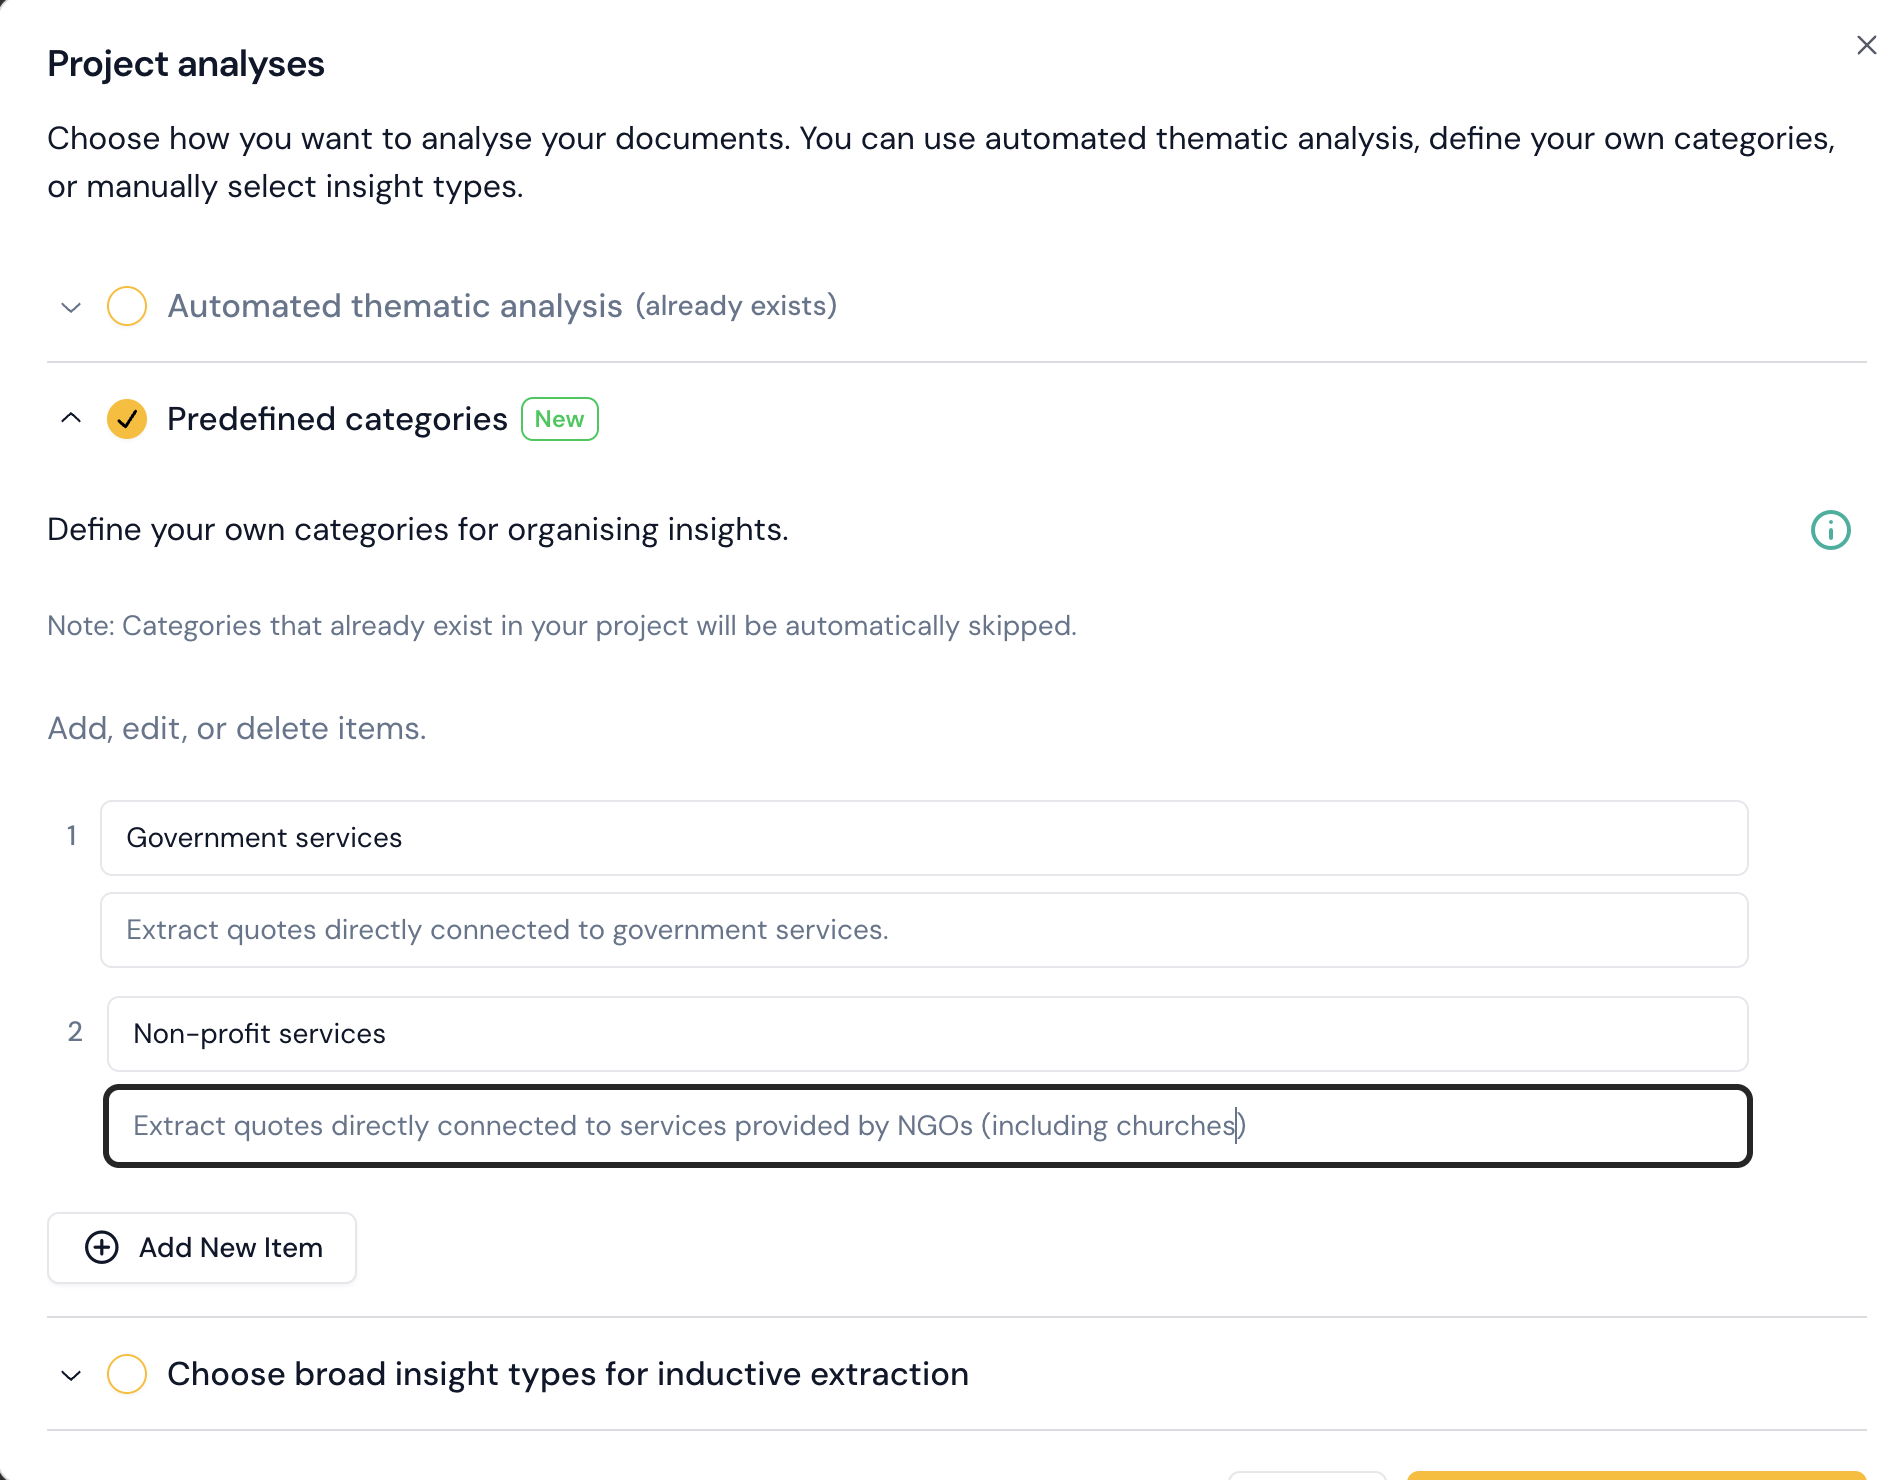
각 카테고리는 선택 사항인 지침을 가질 수 있습니다:
- 지침은 이 카테고리에 대해 AI가 무엇을 추출할지 안내하며, 포함되는 내용의 범위를 넓히거나 좁힐 수 있게 합니다.
- 분류 지침은 인사이트가 그 아래 하위 카테고리로 어떻게 분류되는지를 안내합니다.
- 예시는 전체 분석을 실행하기 전에 AI가 찾아낼 인사이트 종류의 미리보기를 생성할 수 있습니다.
지침이 없는 카테고리도 문제없이 작동합니다. 지침은 카테고리 이름만으로는 의미가 모호하거나, 두 카테고리가 동일한 구절을 놓고 겹칠 수 있을 때 가장 중요합니다.
2단계: 데이터 추출
Skimle은 각 문서를 검토하여 카테고리와 그 지침에 맞는 인사이트를 추출합니다. 추출된 모든 인용문은 원본 문서와 대조하여 검증되므로, 원문에 그대로 등장하지 않는 인용문은 분석 결과에 포함되지 않습니다.
3단계: 인사이트로부터 하위 카테고리 형성
Skimle은 각 카테고리에 배정된 인사이트를 검토하여 하위 카테고리를 형성한 다음, 각 인사이트를 가장 적절한 하위 카테고리로 이동시킵니다. 귀납적 분석이 구조를 갖추는 지점이 바로 여기입니다. 즉, 귀하는 넓은 초점을 제시하고, 그 아래 단계는 데이터에서 비롯됩니다.
참고: 하위 카테고리는 카테고리에 배정된 인사이트가 의미 있는 수에 달할 때만 형성됩니다. 인사이트를 소수만 포착한 카테고리는 평평한 상태로 남으며, 이는 대개 카테고리가 지나치게 좁게 설정되었거나 해당 자료가 존재하지 않는다는 신호입니다.
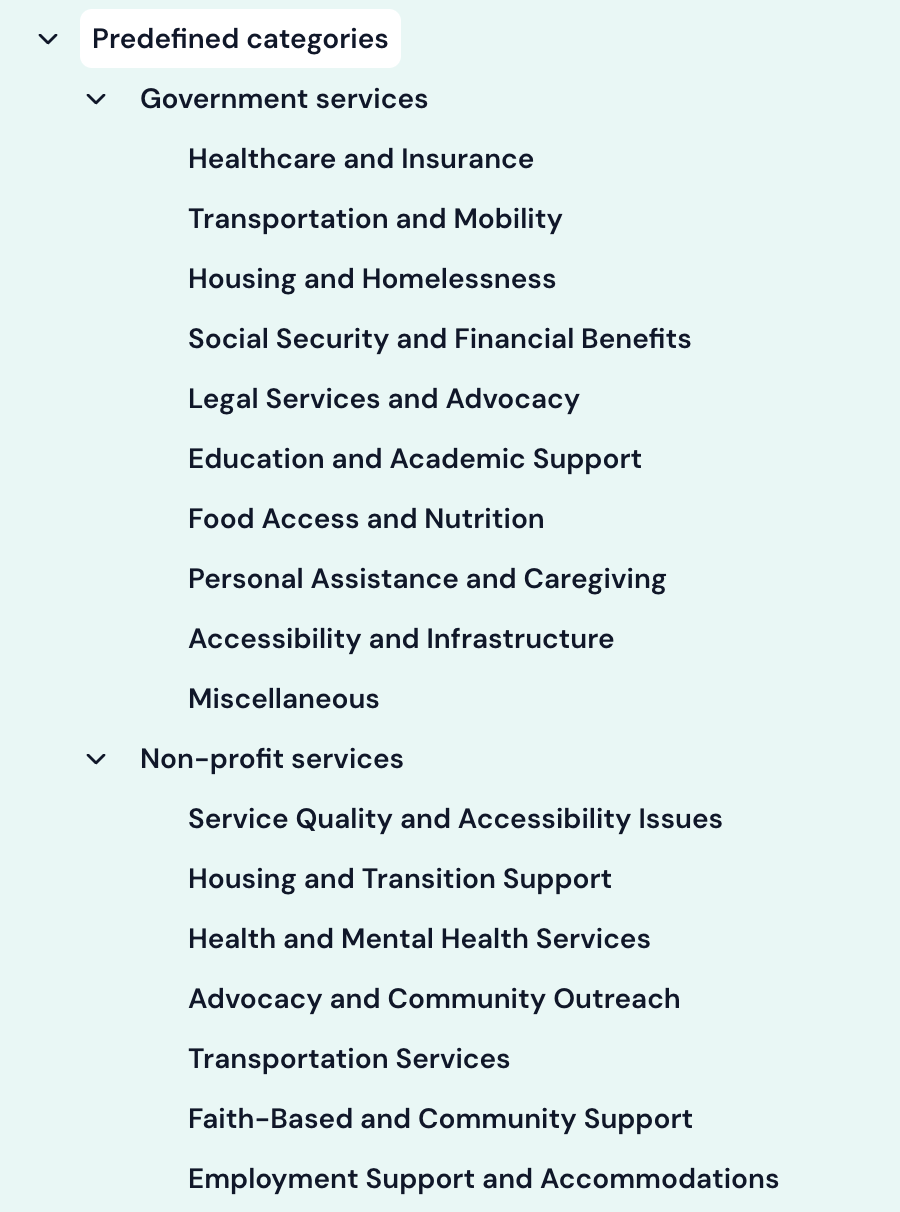
4단계: 카테고리 요약
데이터가 분류되면 Skimle이 각 카테고리에 대한 요약을 작성합니다. 요약은 카테고리 뷰에서 확인할 수 있으며, 여기에서 분석 결과로 생성된 항목의 이름 변경, 병합, 분할, 재구성도 가능합니다.
CSV 파일 가져오기
CSV 파일을 가져올 때, "content" 열의 이름이 저장되어 이 분석 유형의 기본 카테고리를 만드는 데 사용됩니다. 데이터를 가져오기 전에 명확하고 유용한 헤더 행을 설정해야 하는 이유가 하나 더 늘어난 셈입니다. CSV 가져오기 작동 방식에 대한 자세한 내용은 지원되는 파일 형식 및 CSV 가져오기를 참조하십시오.
언제 사용해야 하는지
분석이 카테고리 수준에서 어떤 질문에 답해야 하는지 알고 있다면, 카테고리가 귀하의 프레임워크에서 나온 것이든 Skimle의 제안에서 나온 것이든 사전 정의된 카테고리를 사용하십시오. 문서가 공통된 구조를 공유하고 아무런 입력 없이 그 구조에서 카테고리가 구축되기를 원한다면 자동 주제 분석이 더 빠릅니다. 분류된 카테고리 트리보다 연구 질문에 대한 서술형 분석 답변을 원한다면 에이전틱 분석을 사용하십시오.