AI의 속도로 구현하는 학술적 엄밀성
Skimle은 학자가 학자를 위해 만들었습니다. 공동 창업자 Henri Schildt 교수는 수십 년의 질적 연구 경험이 있으며, Academy of Management Journal과 Organization Science 등 주요 경영학 저널에 논문을 발표했습니다. 그는 NVivo와 MAXQDA의 느리고 불편한 워크플로에 지쳤고, 투명성과 포괄성이 부족한 분석에 ChatGPT가 쓰이는 방식을 우려했습니다. 그래서 엄밀하고 투명한 질적 방법론을 재현하되 그 중심에 AI를 둔 플랫폼으로 Skimle을 만들었습니다.
인터뷰의 초기 코딩은 수작업으로 몇 주가 걸릴 수 있습니다. Skimle은 방법론적 엄밀함을 희생하지 않고 이를 처리하며, 사람이 놓칠 인용을 찾아내는 경우도 많습니다. 모든 주제는 검증된 원문 인용과 연결됩니다. 완전한 감사 추적은 심사자를 만족시킵니다.
교육 자료 →이론적 기여에 집중하게 해 주는 엄밀한 분석
Skimle의 접근 방식은 근거 이론(Glaser & Strauss; Strauss & Corbin)과 Gioia 방법에서 영감을 받았습니다. 동료 심사가 요구하는 체계적이고 투명한 분석을 제공하면서도, 이론에 쓰는 편이 나은 시간을 잡아먹는 몇 주간의 기계적인 코딩은 필요 없습니다. 100개 이상의 언어로 작동하며 프로젝트당 최대 1,000개 문서를 처리합니다.
- 자동 초기 코딩: 모든 인용이 카테고리와 연결됨
- 동료 심사와 방법 투명성을 위한 완전한 양방향 감사 추적
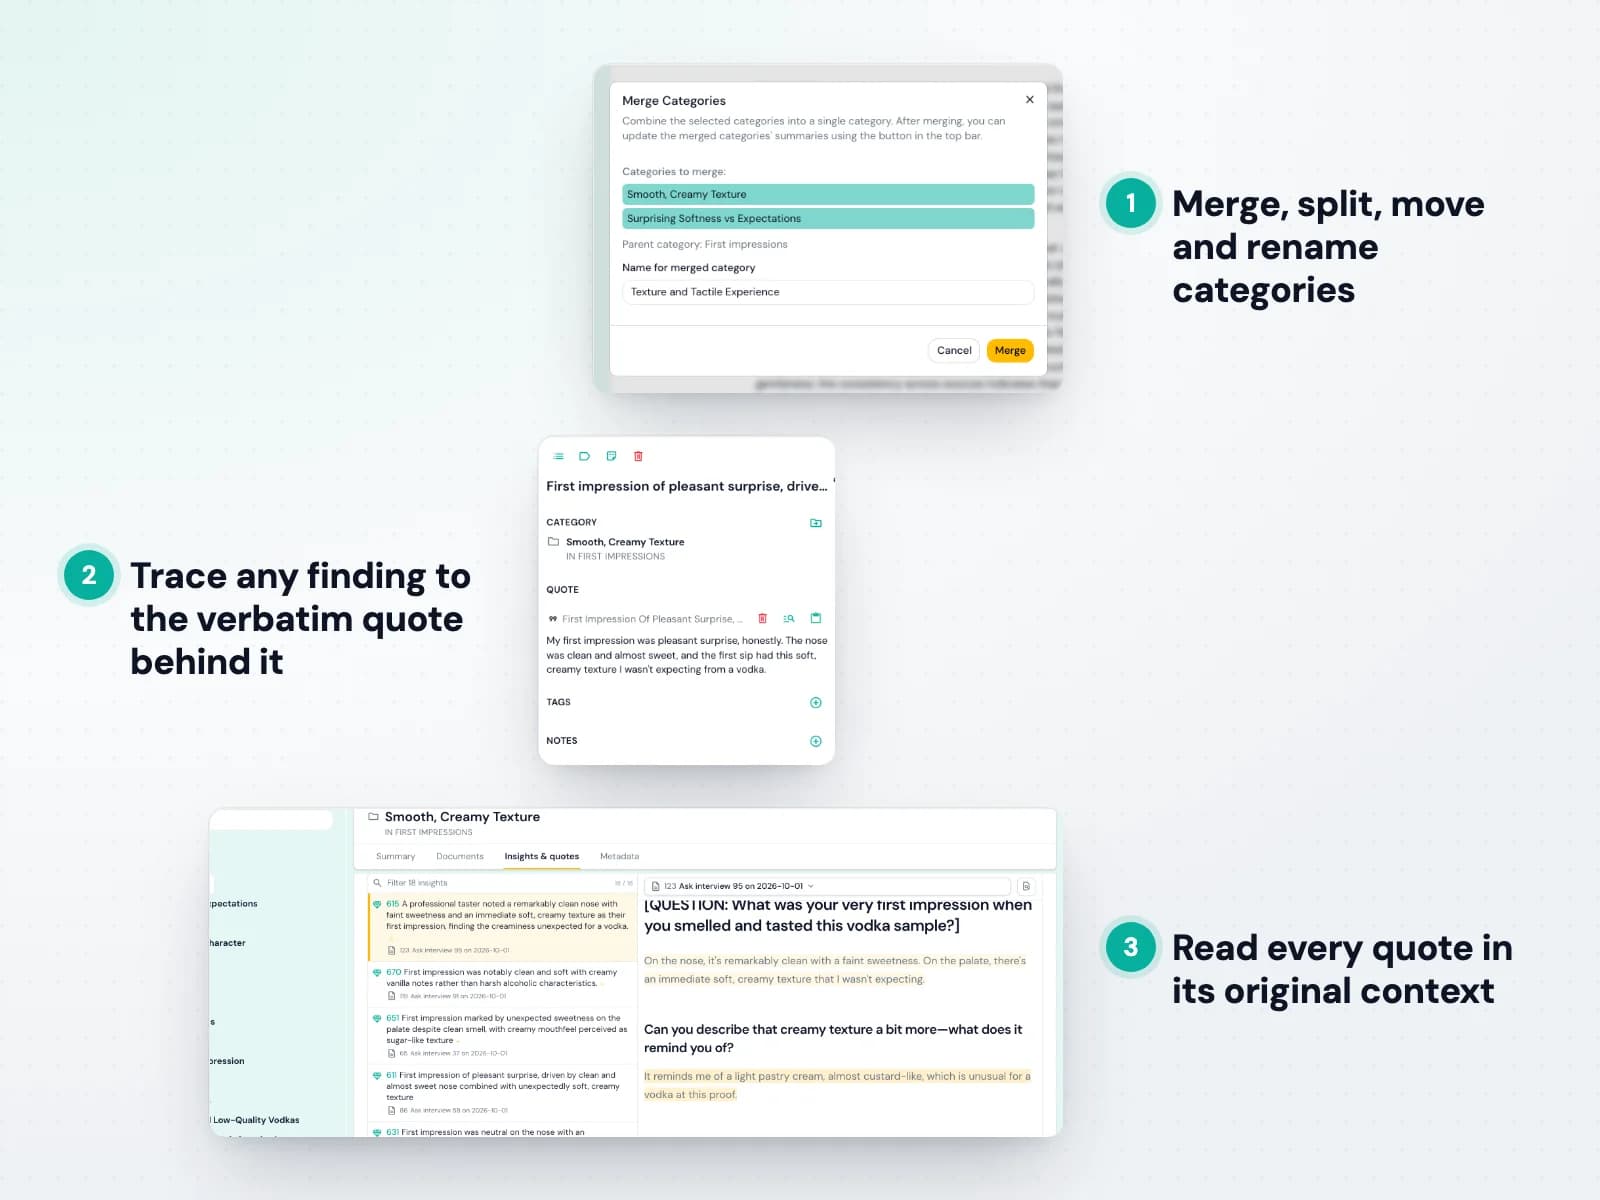
- 직접 통제하는 카테고리 체계: 카테고리를 자유롭게 병합, 분할, 이름 변경, 재구성
- 번역 없이 100개 이상의 언어로 작동
- 인터뷰, 오디오 및 비디오, 책, 문서, 기록 자료 처리
- 할인 요금제 Skimle Academic 제공


인터뷰 전사 및 익명화
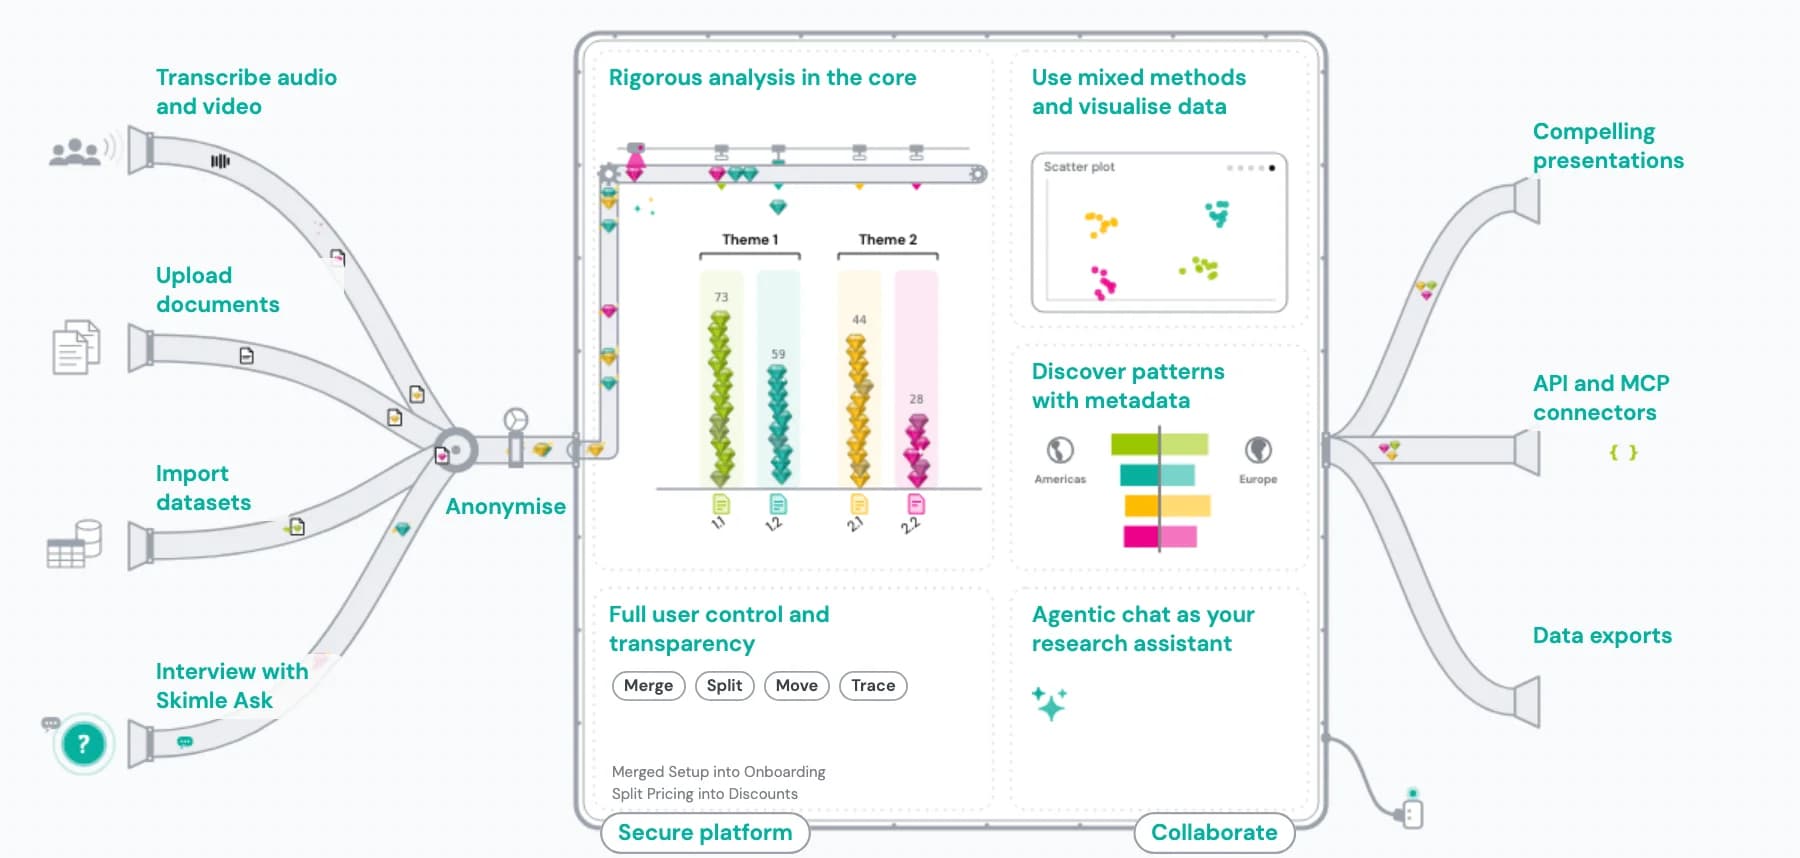
현장 녹음을 외부 서비스로 쓸 수 있는 데이터로 만드는 일은 느리고 비싸며, 그렇게 얻은 녹취록에는 이름, 소속, 장소가 담겨 있어 공유, 보관, 인용 전부터 GDPR과 연구윤리 의무가 생깁니다. Skimle은 EU에서 호스팅되는 안전한 환경 안에서 오디오와 비디오를 전사한 뒤 연구 수준의 가명화로 익명화하므로, 데이터가 GDPR 준수 인프라를 떠나지 않은 채 당일에 규정에 맞고 바로 코딩할 수 있는 녹취록을 얻을 수 있습니다.
작동 방식
- 1. 오디오, 비디오 또는 텍스트 업로드
MP3, M4A, WAV, MP4, MOV, PDF 또는 Word 파일을 바로 업로드하십시오. 외부 전사 서비스가 필요 없고 100개 이상의 언어를 기본 지원합니다.
- 2. 화자 표시와 함께 전사
Skimle은 녹음을 전사하고, 화자 전환을 식별하며, 억양과 다양한 음질도 처리합니다. 분석을 시작하기 전에 결과를 검토하고 수정하십시오.
- 3. 식별자 자동 탐지
Skimle Anonymise는 모든 문서에서 여섯 가지 카테고리(이름, 직함과 역할, 장소, 조직, 날짜, 기타)의 식별자를 표시하며, 파일 간 일관성을 유지해 같은 사람에게 같은 가명을 부여합니다.
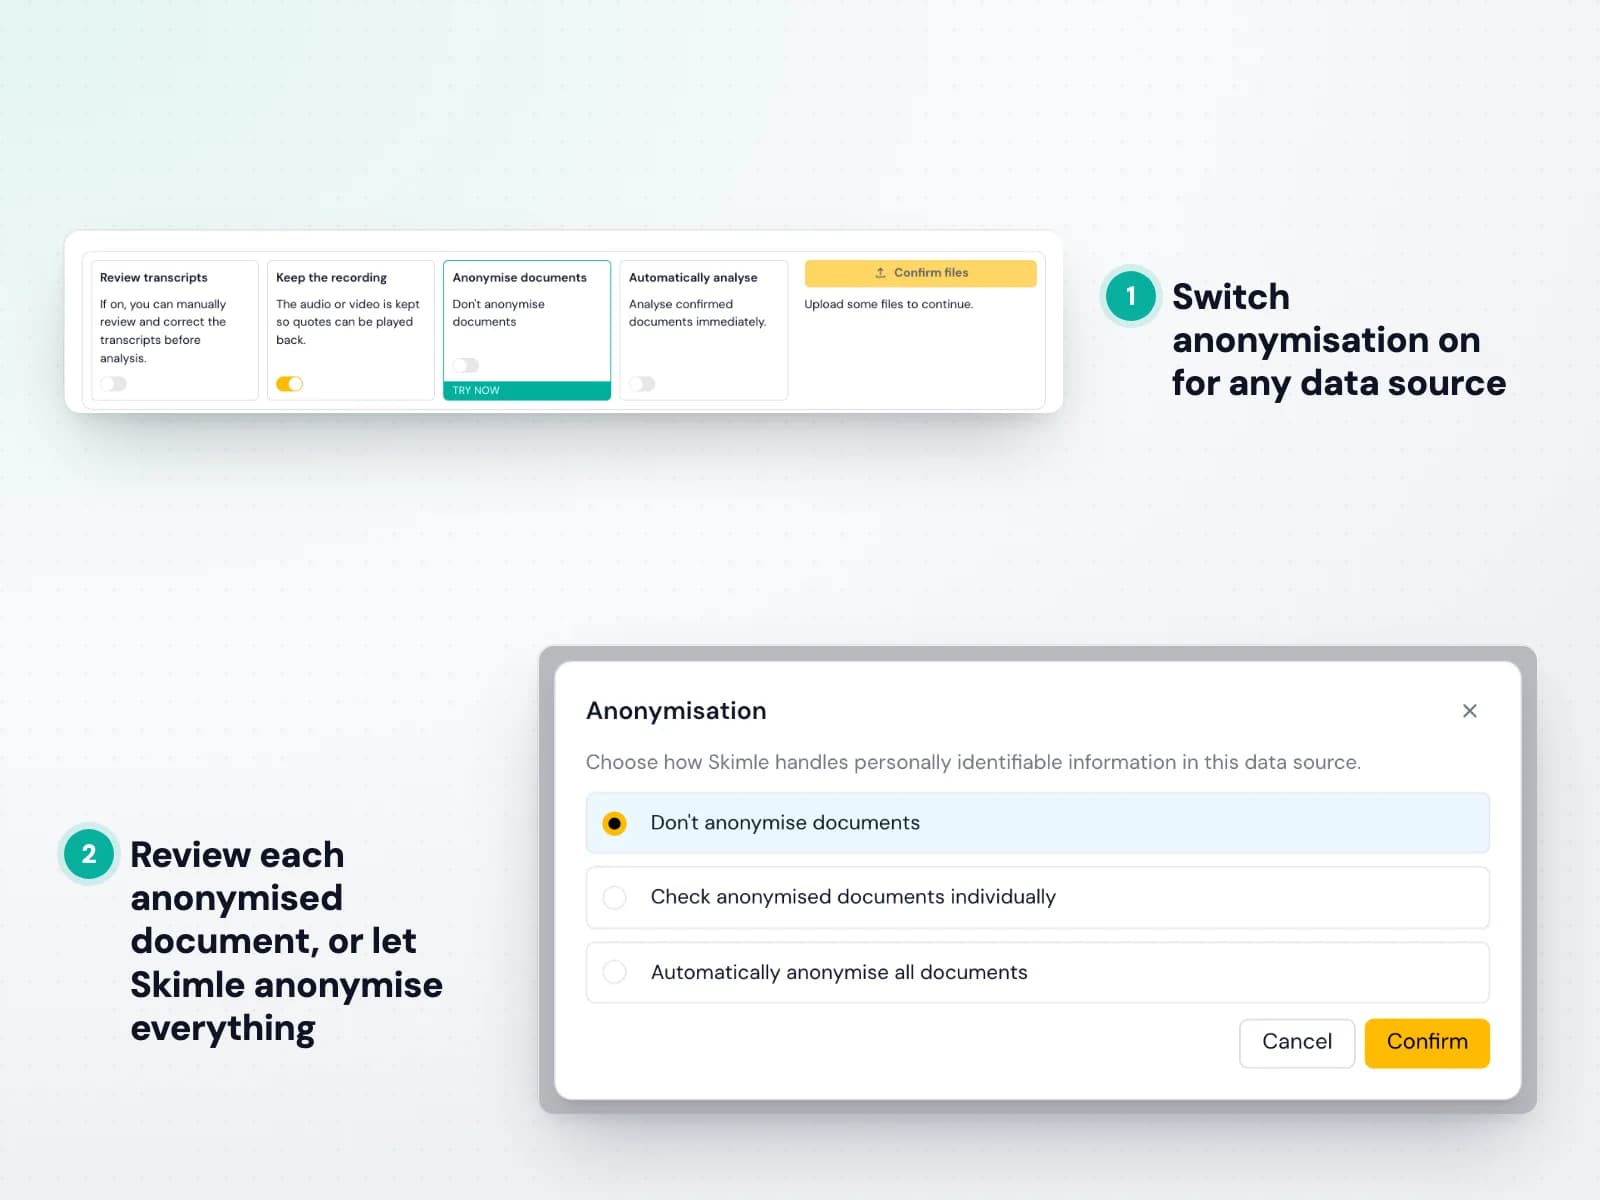
- 4. 익명화 수준 선택
가벼운 가명화, 강력한 가명화, 키를 폐기하는 HIPAA 수준 익명화 중에서 선택하십시오. 카테고리별로 따로 조정하고 평이한 언어로 맞춤 규칙을 추가할 수 있습니다.
- 5. 감사 문서와 함께 내보내기
연구윤리위원회를 위한 PDF 감사 보고서와 Excel 대응표를 내보낸 뒤, 정리된 녹취록을 바로 Skimle의 분석 워크플로로 보내십시오. 원본 오디오는 이후 안전하게 삭제됩니다.


AI 지원 인터뷰 질적 분석 수행하기
40건 이상의 인터뷰를 바탕으로 한 연구는(예를 들어 박사 논문이라면) 풍부한 이론적 기여를 낳아야 하지만, 수동 코딩(표시, 정리, 재코딩, 관리표 작성)이 가용 시간의 대부분을 잡아먹고도 중요한 패턴을 놓칠 수 있습니다. Skimle은 모든 인터뷰를 체계적으로 읽고 원문 인용이 붙은 구조화된 주제 계층을 제공하므로, 오직 연구자만 할 수 있는 이론적 해석에 시간을 쓸 수 있습니다.
작동 방식
- 1. 녹취록 업로드
인터뷰 녹취록을 PDF, Word 또는 일반 텍스트로 끌어다 놓으십시오. Skimle은 어떤 형식의 문서든 받으며 100개 이상의 언어를 기본 지원합니다.
- 2. 연구 질문 설명
분석 초점을 넓게 또는 구체적으로 정하십시오. Skimle은 이론적으로 이해하려는 내용을 중심으로 초기 코딩을 구조화합니다.
- 3. 초기 코드 구조 검토
Skimle은 주제 계층을 만들고, 각 주제를 원본 녹취록의 원문 인용과 연결합니다. 지어낸 것은 없습니다. 모든 코드는 텍스트로 이어집니다.
- 4. 이론적 틀에 맞게 다듬기
형성 중인 이론 모델에 맞게 카테고리를 병합, 분할, 이름 변경, 재구성하십시오. 양방향 투명성 덕분에 어떤 인용이 어떤 코드를 뒷받침하는지 언제든 확인할 수 있습니다.
- 5. 방법 부록용으로 내보내기
카테고리 체계와 뒷받침 인용을 텍스트로, 또는 NVivo, ATLAS.ti, MAXQDA 같은 기존 CAQDAS 프로그램이 지원하는 오픈 소스 REFI-QDA(.qdpx) 형식으로 내보내십시오.

표본 전체에서 혼합 방법 분석 수행
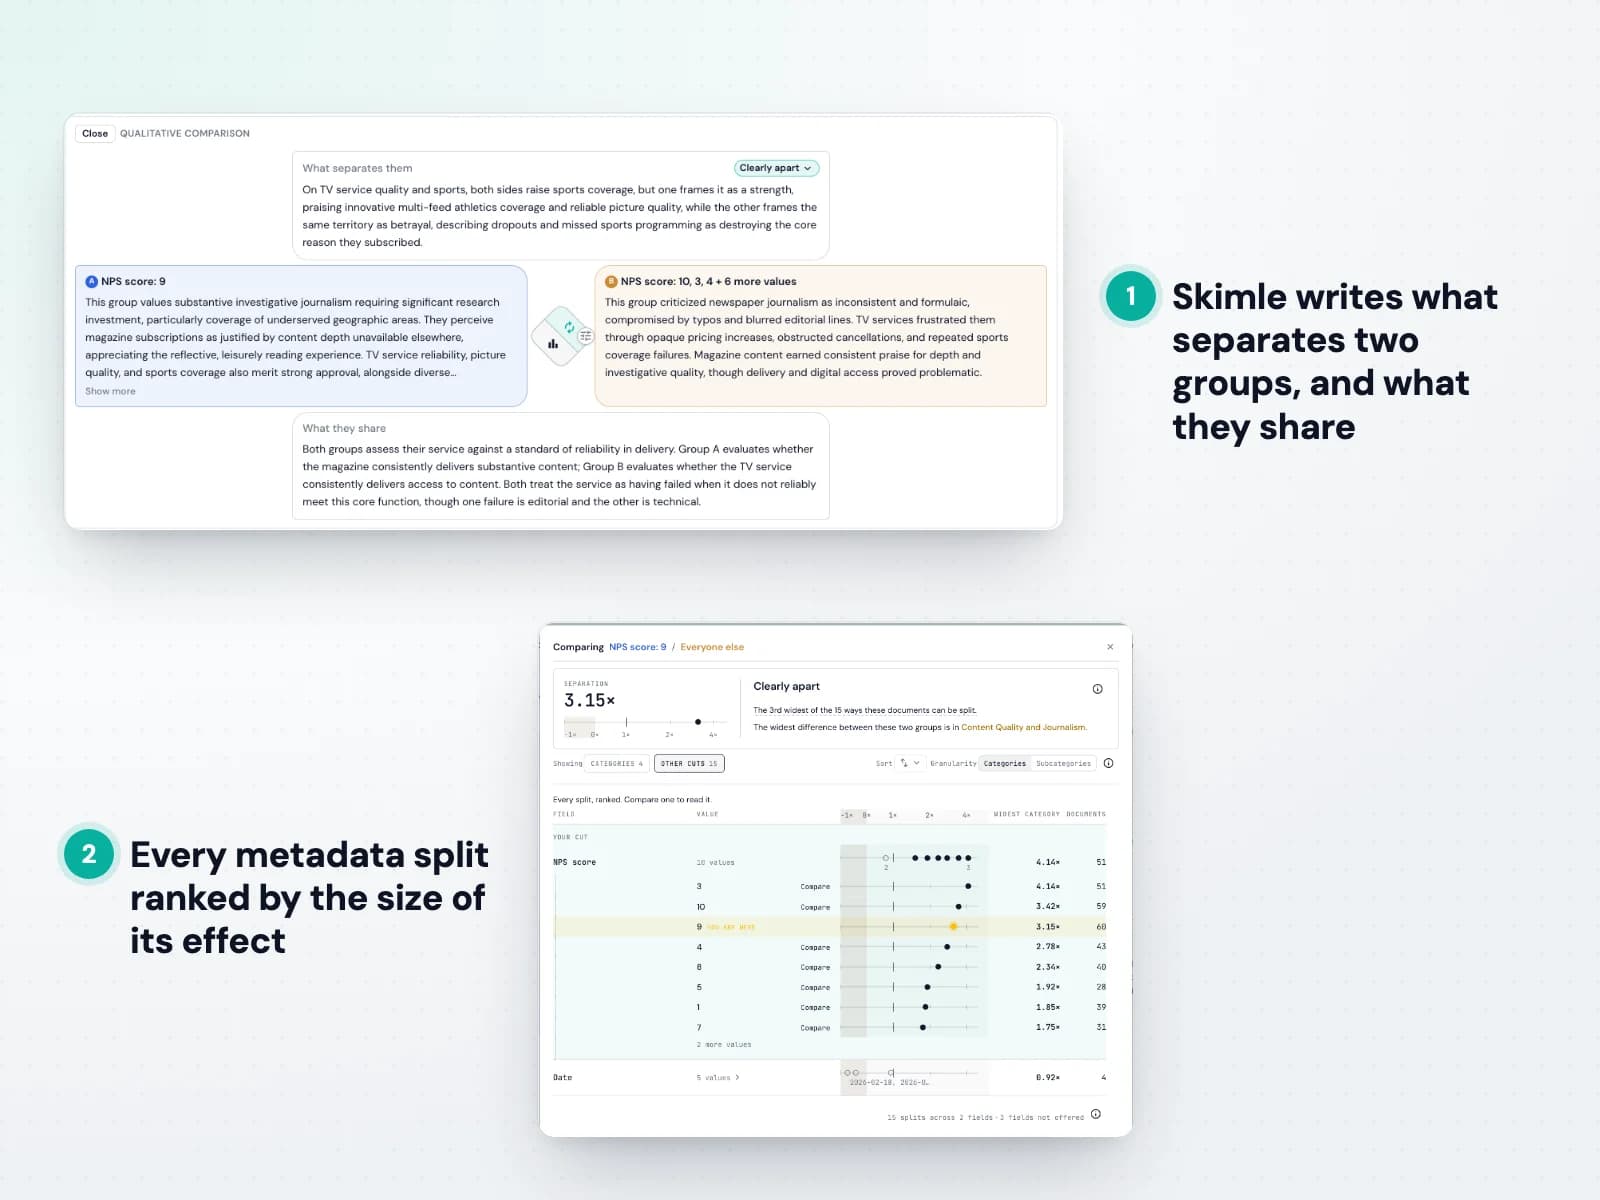
질적 결과는 표본 전반에서 코호트, 역할, 성별, 현장, 조건에 따라 어떻게 달라지는지 보여 줄 수 있을 때 더 큰 힘을 얻습니다. 주제를 참여자 속성과 수작업으로 교차 분석하는 일은 번거롭고 틀리기 쉽습니다. Skimle은 모든 문서에 메타데이터를 붙이고 같은 주제 구조를 어떤 변수로든 나눌 수 있게 하므로, 어느 방법론도 포기하지 않고 풍부한 원문 인용과 수치화된 패턴 사이를 오갈 수 있습니다.
작동 방식
- 1. 문서에 메타데이터 붙이기
각 녹취록에 연구 설계에 중요한 변수(코호트, 역할, 성별, 현장, 조사 차수, 실험 조건)를 직접 또는 CSV 열에서 태그하십시오.
- 2. 질적 분석 실행
Skimle은 전체 코퍼스에 걸쳐 하나의 주제 계층을 만들므로, 모든 참여자가 같은 구조로 코딩됩니다.
- 3. 변수별로 주제 세분화
각 주제가 그룹 간에 어떻게 다른지 확인하고, 어떤 패턴이 보편적인지 특정 코호트에만 해당하는지 찾아내십시오.
- 4. 출현율 정량화
주제의 빈도와 분포를 읽어 세그먼트별로 어떤 코드가 얼마나 흔한지 보고하십시오. 모든 수치는 그것을 만든 인용까지 추적할 수 있습니다.
- 5. 표와 인용 내보내기
논문의 혼합 방법 섹션을 위해 교차표와 뒷받침 인용을 Excel이나 Word로 내보내십시오.

자주 묻는 질문
- 연구에서 Skimle을 인용할 수 있습니까?
- 네. 방법 섹션에서 NVivo나 MAXQDA를 인용하듯 'AI 지원 질적 코딩 소프트웨어'로 기술하십시오. 현재 심사 중인 방법론 논문이 공식 인용 문헌이 될 예정이며, 그 전까지는 요청 시 인용 문구를 제안해 드립니다.
- 동료 심사자가 AI 지원 분석을 받아들입니까?
- 적절한 기록이 있다면 점점 더 그렇습니다. Skimle의 감사 추적은 심사자가 기대하는 것, 즉 모든 주제가 구체적인 인용으로 이어지는 기록되고 체계적인 코딩 과정을 제공하므로 방법 섹션은 대부분 저절로 쓰입니다.
- Skimle은 NVivo나 MAXQDA와 비교해 어떻습니까?
- NVivo와 MAXQDA는 분석에 몇 주를 쓸 수 있고 기관 라이선스가 있는 연구자에게 맞습니다. Skimle은 기계적인 코딩 단계를 자동화하면서(몇 주가 몇 시간으로) 같은 체계적이고 투명한 방법론을 유지하며, 익히는 데는 몇 분이면 됩니다. 많은 연구자가 둘 다 사용합니다. 초기 코딩은 Skimle로, 혼합 방법 통합은 NVivo로 합니다.
- Skimle은 근거 이론에도 쓸 수 있습니까?
- 네. Skimle은 주제를 미리 정하지 않고 데이터에서 드러나게 하는 귀납적 코딩을 지원합니다. 넓은 초점으로 시작해 카테고리 구조가 반복적으로 발전하게 하면, 근거 이론의 개방 코딩과 매우 가깝게 대응합니다.
- 혼합 방법 분석을 할 수 있습니까?
- 네. 각 문서에 메타데이터 변수(코호트, 역할, 성별, 현장, 조건)를 붙이고 그중 어떤 것으로든 주제 구조를 세분화하십시오. 그룹별 주제 빈도와 분포를 얻을 수 있고, 각각 원문 인용까지 추적할 수 있어 논문의 혼합 방법 섹션에 바로 쓸 수 있습니다.
- 연구 데이터는 안전합니까?
- 녹취록은 EU에서 호스팅되는 인프라에서 처리되며 AI 모델 학습에는 절대 사용되지 않습니다. 기관의 연구윤리 요건을 위한 데이터 처리 계약서를 제공하며, 대부분의 IT 보안 요구 사항도 맞출 수 있습니다. 특별한 요구 사항이 있다면 문의해 주십시오.
- 학술 할인을 받을 수 있습니까?
- 네. 유효한 기관 이메일과 소속 페이지가 있는 학계 사용자는 할인된 Skimle Academic 패키지를 구매할 수 있습니다. 연구 그룹이나 연구실을 위한 팀 접근이 필요하다면 기관 라이선스에 대해 문의해 주십시오.
전문가가 전문가를 위해 만들었습니다
Skimle은 50곳 이상의 대학, 정부 기관, 에이전시, 기업에서 1,500명이 넘는 사용자가 만족하며 사용하고 있습니다. 모든 데이터는 EU 안에 저장되며 엄격한 내부 규정에 따라 처리됩니다. 자세한 내용: GDPR 정책 및 서비스 약관.
더 알고 싶으십니까? 다음을 살펴보십시오: Signal & Noise 블로그, 자주 묻는 질문, 업종별 활용 사례. 제품 시연이나 Skimle이 요구 사항에 어떻게 맞는지에 대한 상담도 기꺼이 도와드립니다. Skimle을 만든 회사에 대해 더 알아보기