Rigore accademico alla velocità dell'IA
Skimle è stato creato da accademici per accademici. Il cofondatore, il professor Henri Schildt, vanta decenni di esperienza nella ricerca qualitativa e articoli pubblicati sulle principali riviste di management, fra cui Academy of Management Journal e Organization Science. Stanco dei flussi di lavoro lenti e macchinosi di NVivo e MAXQDA, e preoccupato dal modo in cui ChatGPT viene usato per analisi prive di trasparenza e completezza, ha costruito Skimle come la piattaforma che riproduce una metodologia qualitativa rigorosa e trasparente, ma con l'IA al centro.
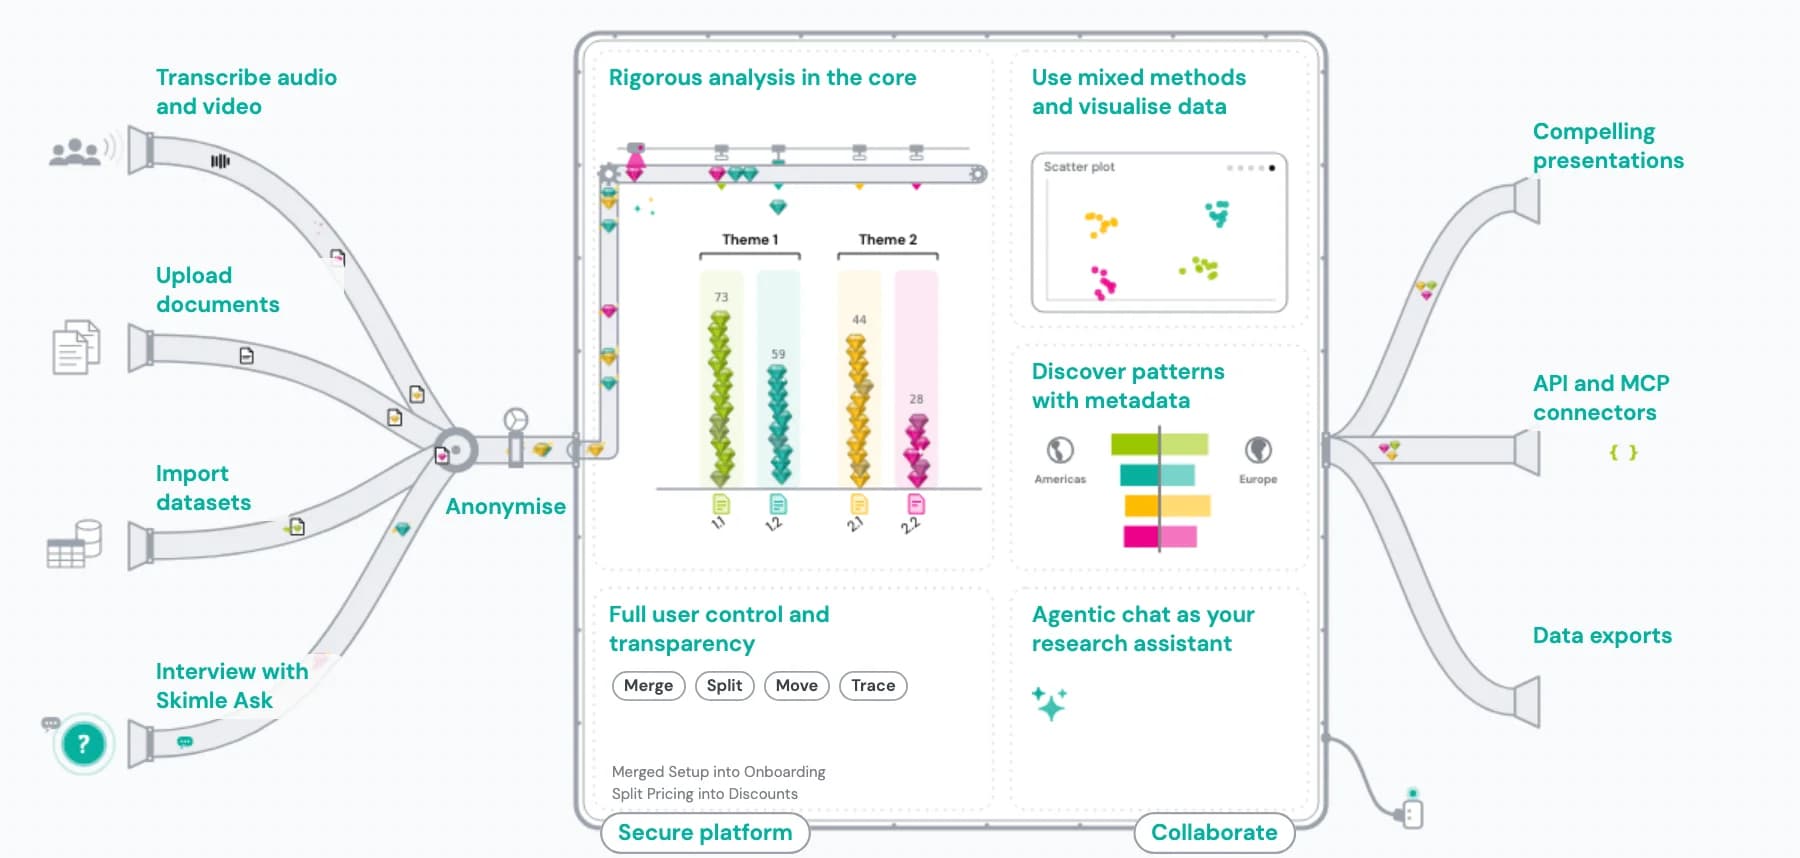
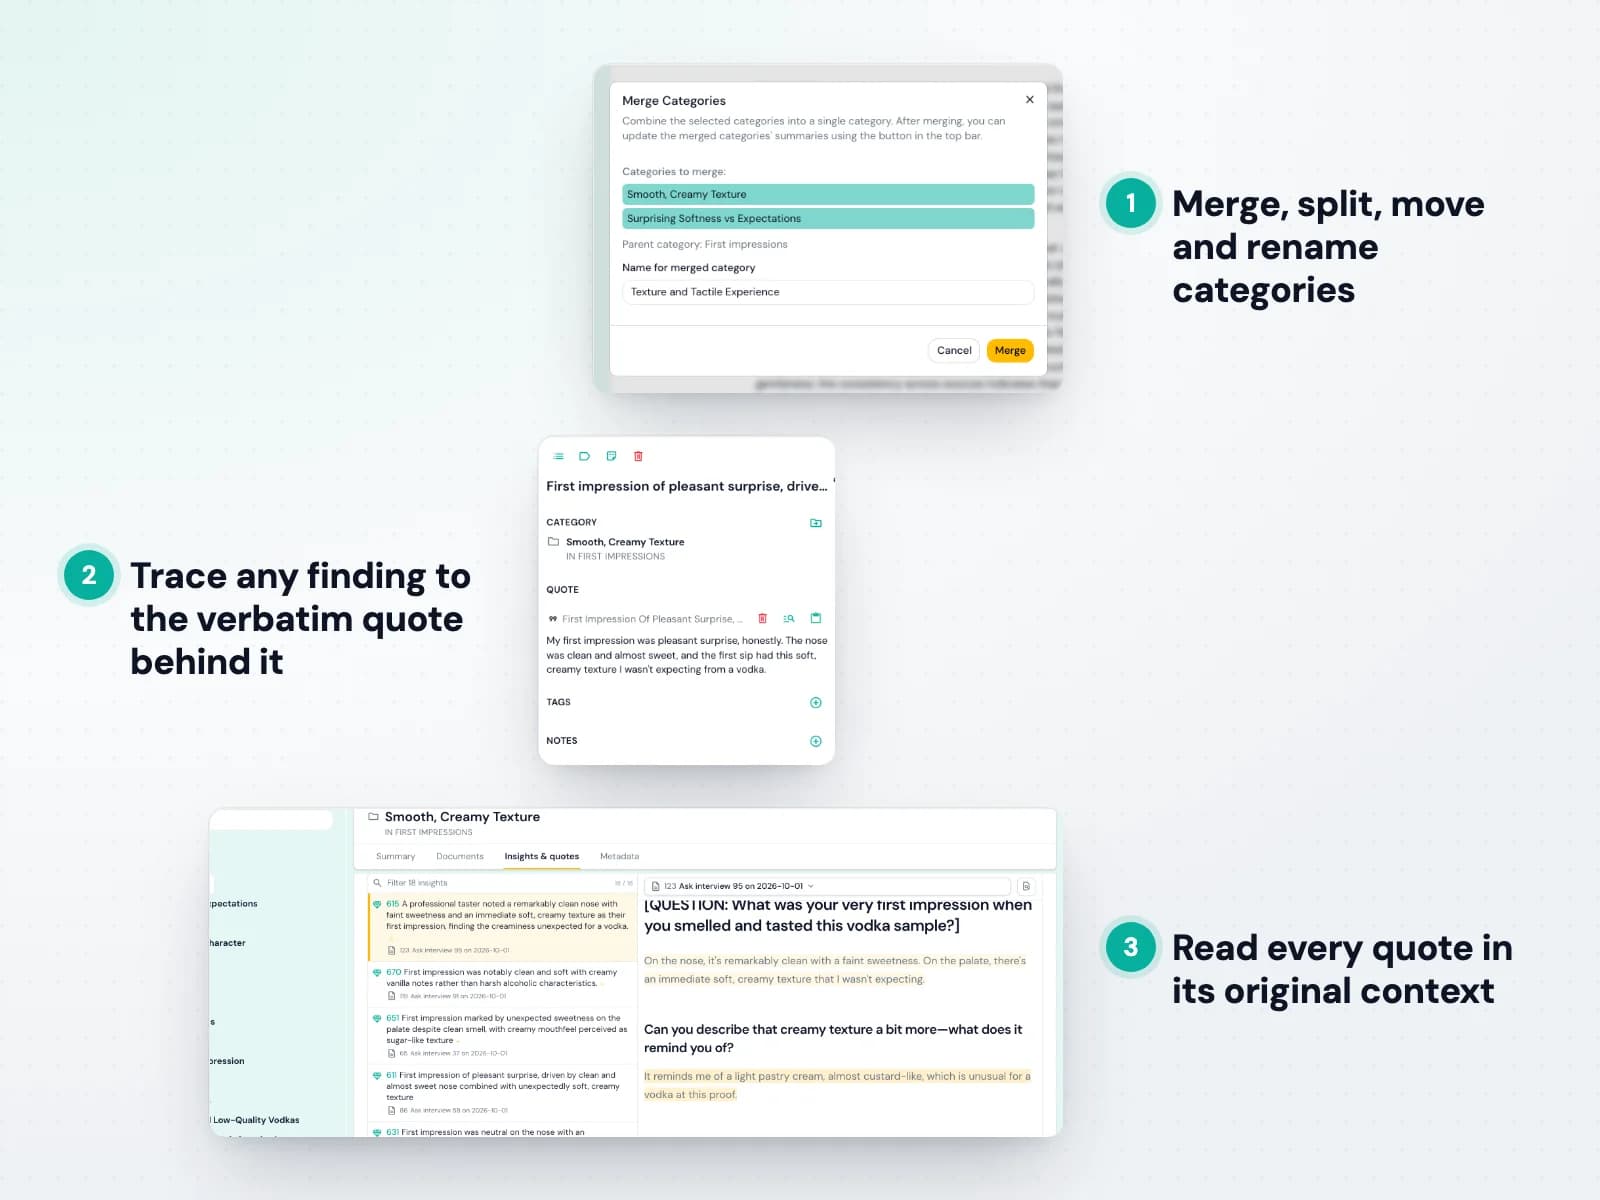
La codifica iniziale delle interviste può richiedere settimane se fatta a mano. Skimle se ne occupa senza sacrificare il rigore metodologico e spesso individua citazioni che una persona si sarebbe persa. Ogni tema rimanda a una citazione testuale verificata. La catena di audit completa soddisfa i revisori.
Materiali didattici →Un'analisi rigorosa che Le lascia concentrarsi sul Suo contributo teorico
L'approccio di Skimle si ispira alla grounded theory (Glaser e Strauss; Strauss e Corbin) e al metodo Gioia. Produce l'analisi sistematica e trasparente che la revisione fra pari richiede, senza le settimane di codifica meccanica che sottraggono tempo alla teoria. Funziona in oltre 100 lingue e gestisce fino a 1.000 documenti per progetto.
- Codifica iniziale automatizzata: ogni citazione collegata alla propria categoria
- Catena di audit completa in entrambe le direzioni per la revisione fra pari e la trasparenza metodologica
- Uno schema di codifica che controlla Lei: unisca, divida, rinomini e riorganizzi liberamente
- Funziona in oltre 100 lingue senza traduzione
- Gestisce interviste, audio e video, libri, documenti e materiale d'archivio
- Skimle Academic — un piano scontato — è disponibile


Trascriva e anonimizzate le interviste
Trasformare registrazioni sul campo in dati utilizzabili è lento e costoso attraverso un servizio esterno, e le trascrizioni che ne derivano contengono nomi, affiliazioni e luoghi che generano obblighi GDPR ed etici prima ancora di poterle condividere, archiviare o citare. Skimle trascrive audio e video nel suo ambiente sicuro ospitato nell'UE, poi anonimizza con una pseudonimizzazione di livello scientifico: ha lo stesso giorno una trascrizione conforme e pronta per la codifica, senza che i dati escano mai da un'infrastruttura conforme al GDPR.
Come funziona
- 1. Carichi audio, video o testo
Carichi direttamente file MP3, M4A, WAV, MP4, MOV, PDF o Word. Nessun servizio di trascrizione esterno e oltre 100 lingue gestite in modo nativo.
- 2. Trascriva con l'indicazione di chi parla
Skimle trascrive la registrazione, riconosce i cambi di interlocutore e gestisce accenti e qualità audio variabili. Esaminate e correggete il risultato prima che l'analisi cominci.
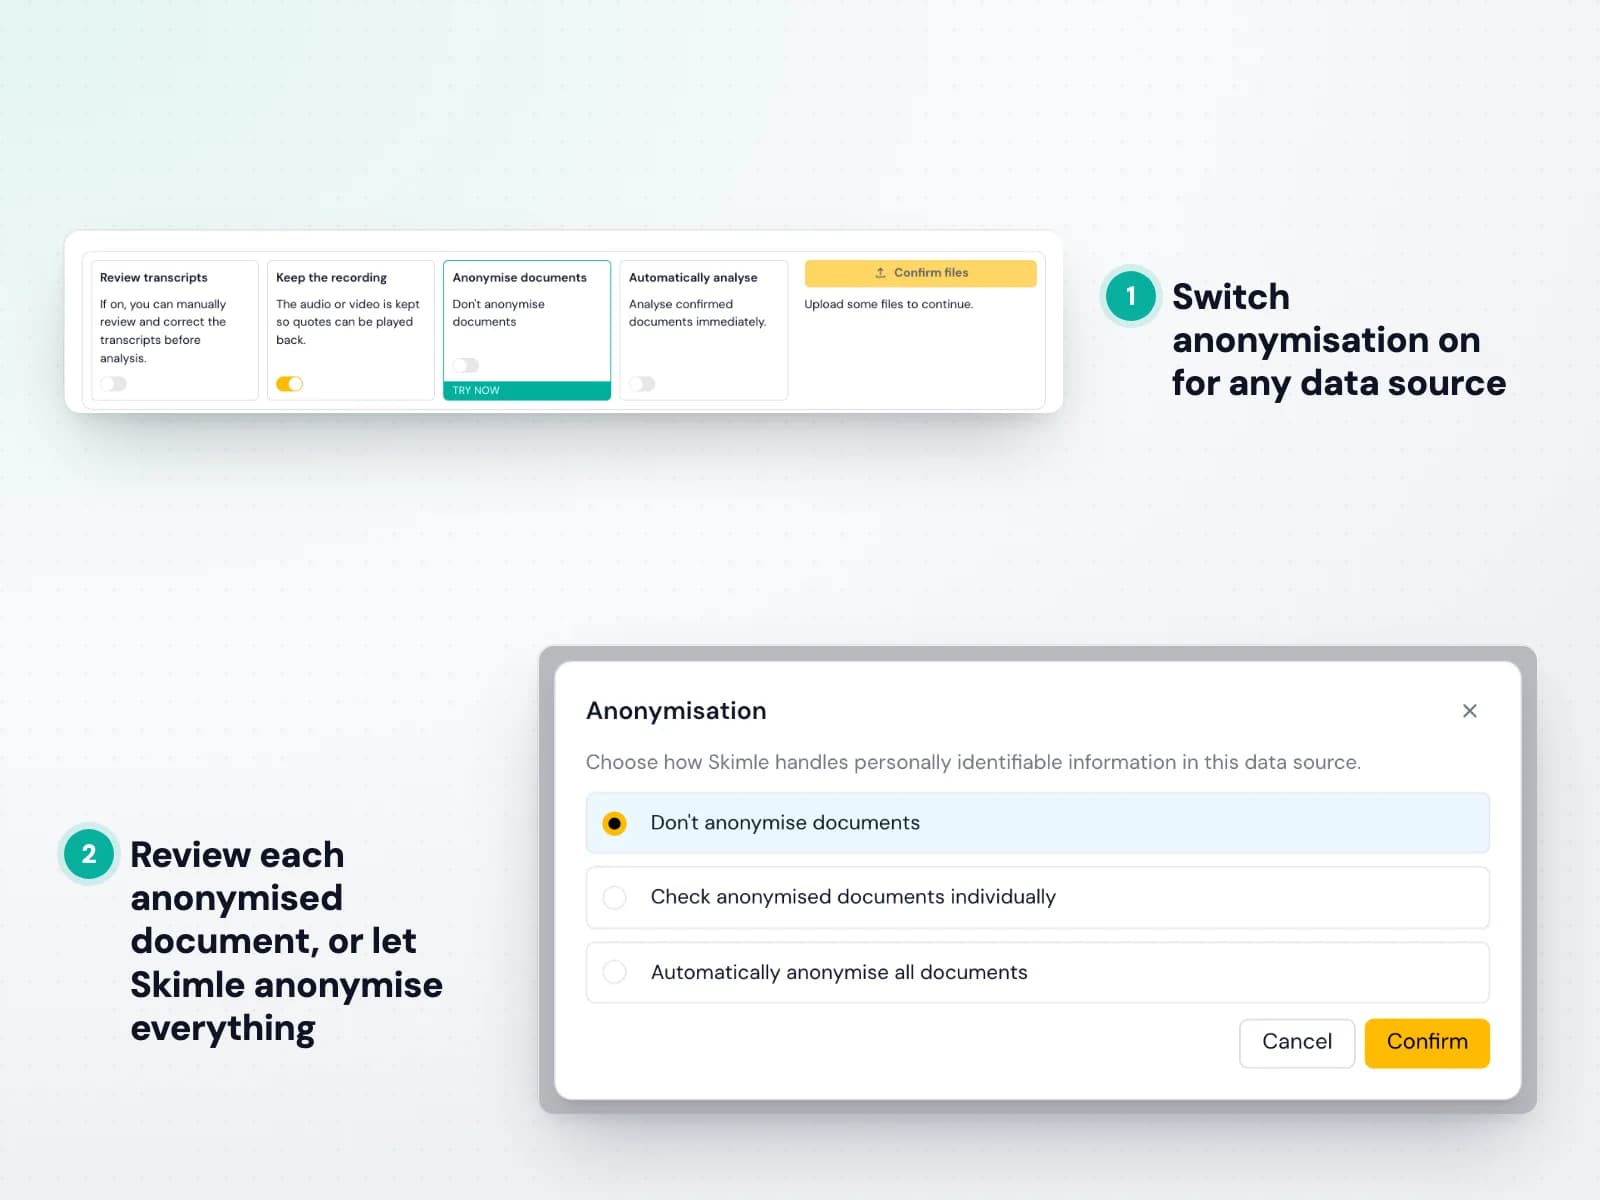
- 3. Rilevate automaticamente gli identificativi
Skimle Anonymise segnala gli identificativi in sei categorie — nomi, titoli e ruoli, luoghi, organizzazioni, date e altro — in tutti i documenti, con coerenza fra file così che la stessa persona mantenga sempre lo stesso pseudonimo.
- 4. Scelga il livello di anonimizzazione
Scelga pseudonimizzazione leggera, pseudonimizzazione forte o anonimizzazione di livello HIPAA con distruzione della chiave. Regoli ogni categoria in modo indipendente e aggiunga regole personalizzate in linguaggio semplice.
- 5. Esporti con la documentazione di audit
Esporti un rapporto di audit in PDF e una tabella di corrispondenze in Excel per il Suo comitato etico, poi porti la trascrizione ripulita direttamente nel flusso di lavoro di Skimle. L'audio originale viene poi eliminato in modo sicuro.


Conducete un'analisi qualitativa delle interviste assistita dall'IA
Una ricerca basata su oltre 40 interviste dovrebbe produrre un contributo teorico ricco (per esempio per il Suo dottorato), ma la codifica manuale — evidenziare, organizzare, ricodificare, tenere elenchi — consuma gran parte del tempo disponibile e rischia comunque di perdere tendenze importanti. Skimle legge ogni intervista in modo sistematico e Le consegna una gerarchia tematica strutturata con citazioni testuali allegate, così può dedicare il Suo tempo all'interpretazione teorica che solo Lei può fornire.
Come funziona
- 1. Carichi le Sue trascrizioni
Trascinate le trascrizioni delle interviste in PDF, Word o testo semplice. Skimle accetta documenti in qualsiasi formato e gestisce oltre 100 lingue in modo nativo.
- 2. Descriva la Sua domanda di ricerca
Stabilisca il Suo fuoco analitico, ampio o mirato. Skimle struttura la codifica iniziale attorno a ciò che vuole comprendere sul piano teorico.
- 3. Esamini la struttura di codifica iniziale
Skimle produce una gerarchia di temi, ciascuno collegato a citazioni testuali tratte dalle trascrizioni originali. Nulla è inventato. Ogni codice risale al testo.
- 4. Affinate secondo il Suo quadro teorico
Unisca, divida, rinomini e riorganizzi le categorie per adattarle al Suo modello teorico in evoluzione. La trasparenza bidirezionale Le permette di verificare in qualsiasi momento quali citazioni sostengono quali codici.
- 5. Esporti per l'appendice metodologica
Esporti il Suo schema di codifica e le citazioni a supporto come testo o nel formato aperto REFI-QDA (.qdpx), supportato dai programmi CAQDAS storici come NVivo, Atlas.TI o MAXQDA.

Conduca un'analisi a metodi misti sul Suo campione
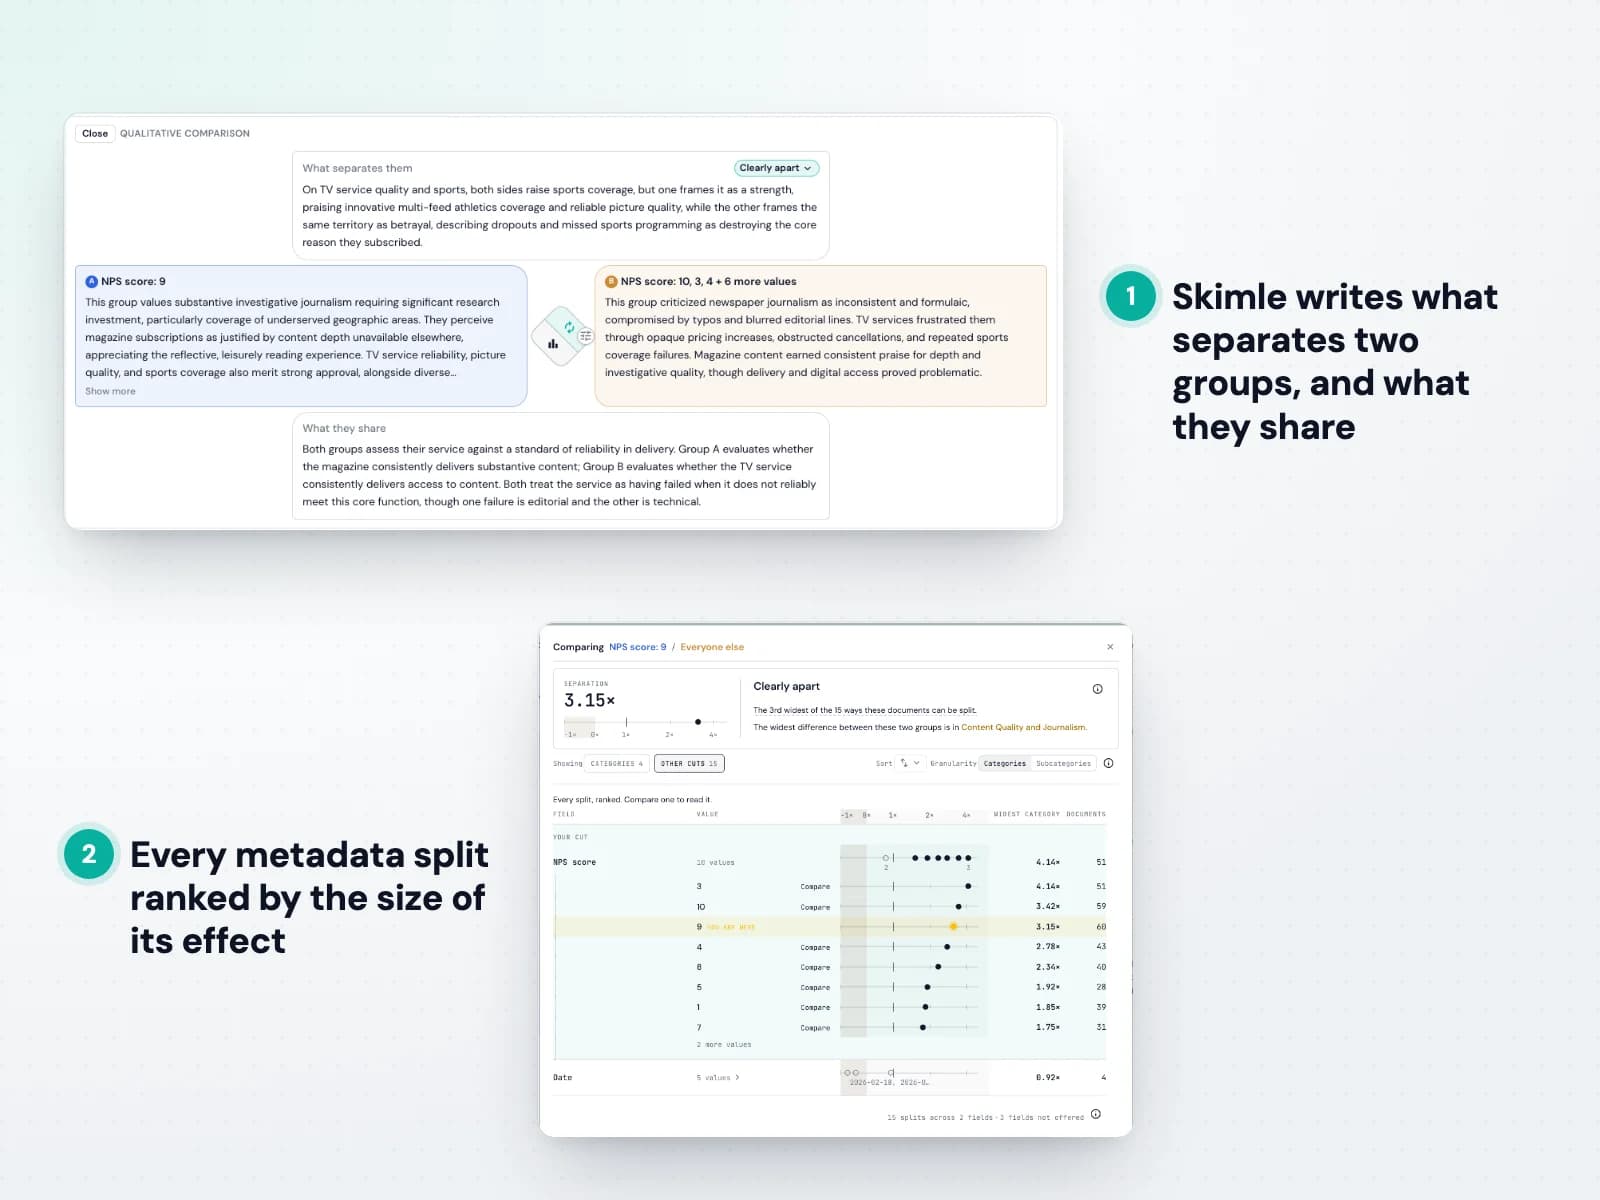
I risultati qualitativi hanno più peso quando può mostrare come variano all'interno del campione: per coorte, ruolo, genere, sede o condizione. Incrociare a mano i temi con gli attributi dei partecipanti è noioso e facile da sbagliare. Skimle associa metadati a ogni documento e Le permette di segmentare la stessa struttura tematica per qualsiasi variabile, così può muoversi fra citazioni testuali ricche e tendenze quantificate senza rinunciare a nessuna delle due metodologie.
Come funziona
- 1. Associate i metadati ai documenti
Etichetti ogni trascrizione con le variabili che contano per il Suo disegno di ricerca — coorte, ruolo, genere, sede, ondata o condizione sperimentale — a mano o da una colonna CSV.
- 2. Avvii l'analisi qualitativa
Skimle costruisce un'unica gerarchia tematica sull'intero corpus, così ogni partecipante è codificato con la stessa struttura.
- 3. Segmentate i temi per variabile
Osservate come varia ogni tema fra i gruppi e capite se una tendenza è universale o propria di una sola coorte.
- 4. Quantificate la diffusione
Legga frequenze e distribuzioni dei temi per riferire quanto è diffuso un codice per segmento, con ogni conteggio tracciabile fino alle citazioni che lo hanno prodotto.
- 5. Esporti tabelle e citazioni
Esporti tabelle incrociate e citazioni a supporto in Excel o Word per la sezione a metodi misti del Suo articolo.

Domande frequenti
- Posso citare Skimle nella mia ricerca?
- Sì. Nella sezione metodi descrivetelo come «software di codifica qualitativa assistita dall'IA», come citereste NVivo o MAXQDA. Abbiamo un articolo metodologico in revisione che fornirà un riferimento formale e, nel frattempo, su richiesta proponiamo volentieri una formulazione.
- I revisori accetteranno un'analisi assistita dall'IA?
- Sempre di più sì, con una documentazione adeguata. La catena di audit di Skimle dà ai revisori ciò che si aspettano: un processo di codifica documentato e sistematico in cui ogni tema risale a citazioni precise, così la sezione metodi si scrive in buona parte da sola.
- Come si confronta Skimle con NVivo o MAXQDA?
- NVivo e MAXQDA sono adatti a chi ha settimane per l'analisi e una licenza d'ateneo. Skimle automatizza la fase di codifica meccanica — da settimane a ore — mantenendo la stessa metodologia sistematica e trasparente, e impararlo richiede minuti. Molti ricercatori li usano entrambi: Skimle per la prima passata di codifica e NVivo per l'integrazione a metodi misti.
- Skimle funziona per la grounded theory?
- Sì. Skimle supporta la codifica induttiva, in cui i temi emergono dai dati anziché essere imposti in anticipo. Partite da un'impostazione ampia e lasciate che la struttura delle categorie si sviluppi per iterazioni, un percorso molto vicino alla codifica aperta della grounded theory.
- Posso condurre un'analisi a metodi misti?
- Sì. Associate variabili di metadati a ciascun documento — coorte, ruolo, genere, sede, condizione — e segmentate la struttura tematica secondo una qualsiasi di esse. Ottenete frequenze e distribuzioni dei temi per gruppo, ciascuna tracciabile fino alle citazioni testuali e pronta per la sezione a metodi misti del Suo articolo.
- I miei dati di ricerca sono al sicuro?
- Le Sue trascrizioni vengono elaborate su un'infrastruttura ospitata nell'UE e non sono mai usate per addestrare modelli di IA. Forniamo accordi sul trattamento dei dati per i requisiti etici degli atenei e riusciamo a soddisfare la maggior parte delle esigenze di sicurezza informatica. Ci scriva con i Suoi requisiti specifici.
- Posso avere uno sconto accademico?
- Sì. Chi ha un indirizzo istituzionale valido e una pagina di affiliazione può acquistare il pacchetto scontato Skimle Academic. Ci contatti per le licenze d'ateneo se Le serve l'accesso di gruppo per un team di ricerca o un laboratorio.
Creato da professionisti, per professionisti
Skimle conta oltre 1.500 utenti soddisfatti in più di 50 università, enti pubblici, agenzie e aziende. Tutti i dati sono conservati nell'UE e trattati secondo le nostre rigorose politica GDPR e i nostri termini di servizio.
Vuole saperne di più? Esplori il nostro blog Signal & Noise, le nostre domande frequenti e i casi d'uso per settore. Saremo lieti anche di mostrarLe il prodotto o di valutare come Skimle può rispondere alle Sue esigenze. Scopra di più sull'azienda dietro Skimle